Wesentliche Erkenntnisse
- Der Systemtest bewertet Ihre vollständig integrierte Anwendung End-to-End.
- Im Gegensatz zu Unit- oder Integrationstests erfasst der Systemtest Fehler, die nur auftreten, wenn Komponenten interagieren, wie inkompatible Schemas, Race Conditions, Fehler bei verteilten Transaktionen und fehlerhafte Timeout-Richtlinien.
- Der Prozess erfordert klare Systemgrenzen, Eintrittskriterien, realistische Testumgebungen, die Produktionstopologie und Datenumfang widerspiegeln, sowie Austrittskriterien, die über einfache Erfolgsquoten hinausgehen.
- Effektive Systemtests verwenden mehrschichtige Strategien, priorisieren Hochrisiko-Workflows über Abdeckungszahlen, umfassen Fehlerpfade und Edge Cases und validieren vollständige Geschäftsergebnisse einschließlich Nebeneffekte wie Datenbankänderungen und Audit-Logs.
- Produktionsvorfälle sollten in die Teststrategie zurückfließen, um fehlende Abdeckung hinzuzufügen, Assertions zu stärken, Umgebungsrealismus zu verbessern und einen kontinuierlichen Verbesserungszyklus zu schaffen.
So bauen Sie Systemtests auf, die diese Fehler vor der Veröffentlichung erfassen 👇
Was ist ein Systemtest?
Teams verwechseln den Systemtest oft mit einem einfachen End-to-End-Durchklicken und fragen sich dann, warum die Produktion immer noch abstürzt, nachdem alles „bestanden“ wurde. Der Systemtest in der Softwareentwicklung ist die Ebene, auf der Ihr Team das vollständig integrierte Produkt sowohl gegen funktionale Anforderungen als auch gegen nicht-funktionale Erwartungen wie Performance und Sicherheit validiert.
Die praktische Herausforderung ist der Umfang. Ohne eine definierte Grenze können zwei Ingenieure das „gleiche“ System testen und unterschiedliche Bereiche abdecken, wobei echte blinde Flecken übrig bleiben, die niemand bemerkt, bis ein Vorfall die Frage erzwingt. Systemtest im Softwaretest ist hauptsächlich Black-Box: Das Testdesign beginnt bei Anforderungen und beobachtbarem Verhalten, obwohl Ihr Team möglicherweise immer noch Logs, Traces und Service-Metriken verwendet, um Fehler zu diagnostizieren, ohne die interne Implementierung selbst zum Testobjekt zu machen.
Für einen genaueren Blick darauf, wie sich diese Ebene vom Prüfen eines Systems gegen seine eigene Spezifikation unterscheidet, siehe system integration testing.
Bevor Sie einen einzigen Testfall schreiben, definieren Sie die Systemgrenze. Eine klare Linie zwischen dem, was im Umfang liegt und was nicht, verhindert, dass Ihr Team annimmt, dass jemand anderes die Integrationspunkte besitzt, und gibt Ihnen eine fertige Antwort, wenn Stakeholder fragen, warum ein Szenario nicht abgedeckt wurde.
Diese Grenze umfasst in der Regel interne Anwendungen und Services, Datenbanken, Caches sowie Message Queues. Dazu kommen unterstützte Browser und Endgeräte, externe APIs und die Authentifizierungsinfrastruktur sowie der gesamte Observability-Stack.
Bei Microservices und Cloud-nativen Architekturen wird diese Abgrenzung schwieriger, da sich ein Produkt oft über mehrere Repositories und Deployment-Pipelines erstreckt. Legen Sie deshalb schon vor Testbeginn schriftlich fest, was dazugehört, was nicht, und wie mit Abhängigkeiten von Drittanbietern umgegangen wird.
aqua cloud ist eine KI-gestützte Lösung für Test- und Anforderungsmanagement. Sie vereint Testfälle, Anforderungen, Testszenarien, Ausführungsergebnisse, Fehler und Automatisierung in einem zentralen System mit vollständiger Nachverfolgbarkeit – und ersetzt damit die verstreuten Tabellen und unverbundenen Tools, auf die sich die meisten Teams heute noch verlassen. aqua Intelligence nutzt RAG-basiertes Grounding, um aus Ihrer eigenen Projektdokumentation, Ihren Standards und Ihrer Terminologie zu lernen, sodass die generierten Testfälle wirklich zu Ihrem Produkt passen, statt wie generische Vorlagen zu wirken. Für komplexe Szenarien auf Systemebene, die Edge Cases und Fehlerpfade abdecken, hilft aqua Intelligence Ihrem Team, diese schneller zu erstellen und die Abdeckung gegenüber den Anforderungen jederzeit im Blick zu behalten. Native Integrationen mit Jira – inklusive bidirektionaler Synchronisation – sowie mit Jenkins, Azure DevOps und Confluence sorgen dafür, dass Ihre Systemtests fest in der Pipeline verankert bleiben, die Ihr Team ohnehin schon nutzt.
Erstellen Sie intelligentere, projektspezifische Systemtests mit 100% Rückverfolgbarkeit und Intelligence AI
Systemtest vs. Integrationstest vs. UAT
Teams behandeln diese drei Ebenen häufig als austauschbar – mit der Folge, dass echte Lücken in der Testabdeckung entstehen: Jeder geht davon aus, eine andere Phase habe etwas bereits geprüft, das in Wirklichkeit niemand getestet hat. Unit-Tests bestätigen, dass eine einzelne Funktion korrekt arbeitet. Integrationstests bestätigen, dass Komponenten Daten korrekt austauschen. Systemtests bestätigen, dass das vollständige, integrierte System unter realistischen Bedingungen korrekt funktioniert. UAT bestätigt, dass das Ergebnis den Anforderungen des Business entspricht.
| Aspekt |
Integrationstest |
Systemtest |
UAT |
| Umfang |
Schnittstellen zwischen Komponenten |
Vollständig integriertes System |
Geschäftsanforderungen |
| Primäres Ziel |
Daten- und Kontrollfluss validieren |
Funktionales und nicht-funktionales Verhalten validieren |
Geschäftsakzeptanz bestätigen |
| Umgebung |
Kontrollierte Integrationsumgebung |
Produktionsähnliche Umgebung |
Benutzerseitige Akzeptanzumgebung |
| Typische Eigentümer |
Entwickler und QA |
QA, Entwickler, SRE, Sicherheit |
Product Owner und Business User |
| Hauptnachweis |
Schnittstellen- und Vertragsergebnisse |
End-to-End-Ergebnisse, Logs, Metriken und Traces |
Formelle Akzeptanz oder Freigabe |
Diese Ebenen bauen aufeinander auf, anstatt sich gegenseitig zu ersetzen. Ein Build, der Integrationstests besteht, benötigt immer noch Systemtests, um zu bestätigen, dass er sich unter Last korrekt verhält und Fehlerpfade behandelt. Ein Build, der Systemtests besteht, benötigt immer noch UAT, da technische Korrektheit und Geschäftsakzeptanz separate Fragen mit separaten Eigentümern sind. Wenn Sie den Umfang gegen eine verwandte Disziplin abwägen, deckt unsere Aufschlüsselung von system vs functional testing ab, wo die Grenze liegt. Mit dieser klaren Grenze ist die nächste Frage, was tatsächlich schiefgeht, wenn diese Ebene übersprungen wird.
Systemtests und Abnahmetests sind eigentlich keine Testtechniken, sondern Teststufen: Beim Systemtest wird beispielsweise die gesamte Funktionalität geprüft. Es handelt sich um einen gründlichen Test, der auch Negativfälle sowie detaillierte Testfälle mit einschließt.
Additional_Check7172
Gepostet in
Reddit
Warum Systemtests wichtig sind
Systemtests zu überspringen oder zu hetzen, spart Ihrem Team selten wirklich Zeit. Der Aufwand verschiebt sich lediglich nach hinten – und wird dort teurer, sowohl an Arbeitsstunden für die Entwicklung als auch am Vertrauen der Kunden.
Einzelne Bestandteile können ihre isolierten Tests problemlos bestehen, während das zusammengesetzte System an nicht zueinander passenden Datenformaten oder an zeitlichen Konflikten zwischen gleichzeitig ablaufenden Prozessen scheitert, die erst sichtbar werden, wenn alles zusammenläuft. Ihre Schnittstelle liefert in der Entwicklung womöglich korrekte Antworten, bricht dann aber unter der Last des Echtbetriebs zusammen oder offenbart Sicherheitslücken bei der Anmeldung, die vorher niemandem aufgefallen sind. Echte Nutzer bringen zusätzliches Risiko mit: Sie geben doppelte Bestellungen auf, brechen Vorgänge mitten in der Abwicklung ab und wechseln während einer Sitzung den Browser – und lösen damit Grenzfälle aus, die Ihre Geschäftsregeln nie berücksichtigt haben.
Auch Unterschiede in der Konfiguration bergen ein Risiko, das sich nicht ignorieren lässt. Umgebungsvariablen, einzeln zu- oder abschaltbare Funktionen und Weiterleitungsregeln können das Verhalten verändern, ohne dass auch nur eine einzige Zeile Quellcode angefasst wird. Nur ein Test in einer realistischen Umgebung deckt solche Abweichungen auf, bevor es die Kunden tun.
Auch wirtschaftlich ist die Sache eindeutig: Einen Fehler bei der Zugangskontrolle oder ein Datenintegritätsproblem im laufenden Betrieb zu beheben, kostet deutlich mehr, als ihn bereits im Systemtest zu entdecken – rechnet man Notfall-Patches, die Reaktion auf Störfälle und Reputationsschäden mit ein. Entscheidungsträger brauchen belastbare Daten, um Releases freizugeben, und genau die liefern Ergebnisse aus Systemtests, Leistungsmessungen und die Abdeckung der Anforderungen.
Arten von Systemtests
Systemtests in der Softwareentwicklung umfassen mindestens acht eigenständige Disziplinen, jede mit eigenen Werkzeugen, Zuständigkeiten und typischen Fehlerquellen. Sie als eine einzige, generische Aufgabe zu behandeln, ist einer der häufigsten Gründe, warum Lücken in der Testabdeckung überhaupt erst entstehen.
| Typ |
Was es prüft |
Häufiger Fokus |
| Funktional |
Vollständige Workflows End-to-End |
Zahlungen, Registrierung, Auftragsverarbeitung, Audit-Logs |
| Performance |
Verhalten unter realistischer Last |
Load-, Stress-, Spike- und Ausdauertests |
| Zuverlässigkeit & Resilienz |
Wiederherstellung nach Störungen |
Knotenausfälle, Netzwerklatenz, Datenbankausfälle |
| Sicherheit |
Angriffsfläche und Zugriffskontrollen |
Penetrationstests, Vulnerability-Scanning, Missbrauchsfälle |
| Usability & Accessibility |
Tatsächliche Benutzeraufgabenerledigung |
Navigation, Screenreader-Unterstützung, Tastaturzugriff |
| Kompatibilität |
Unterstützte Umgebungen |
Browser, Geräte, OS-Versionen, Locales |
| Installation & Migration |
Deployment- und Upgrade-Pfade |
Rollbacks, Schemaänderungen, Datenerhaltung |
| Backup & Disaster Recovery |
Wiederherstellungszuverlässigkeit |
Recovery-Zeit, Datenverlust-Ziele |
Einige dieser Disziplinen verdienen besondere Aufmerksamkeit. Performance-Tests unterteilen sich in Lasttests unter erwarteter Auslastung und Stresstests, die die Belastungsgrenzen des Systems ausloten. Spitzenlast- und Dauertests wiederum decken Traffic-Spitzen und Speicherlecks auf, die sich erst über längere Zeiträume hinweg zeigen. Noch einen Schritt weiter gehen Zuverlässigkeitstests: Hier werden gezielt Knotenausfälle und Zeitüberschreitungen bei Abhängigkeiten provoziert, um zu prüfen, ob das System die Datenkonsistenz wahrt und die vorgesehenen Wiederherstellungsziele einhält. Kein Team führt alle acht Arten von Systemtests bei einem einzigen Release durch – weshalb der nächste Abschnitt zeigt, wie sich diese Tests zu einem wiederholbaren Prozess zusammenstellen lassen.
Der Systemtestprozess
 KI-generiertes Bild.
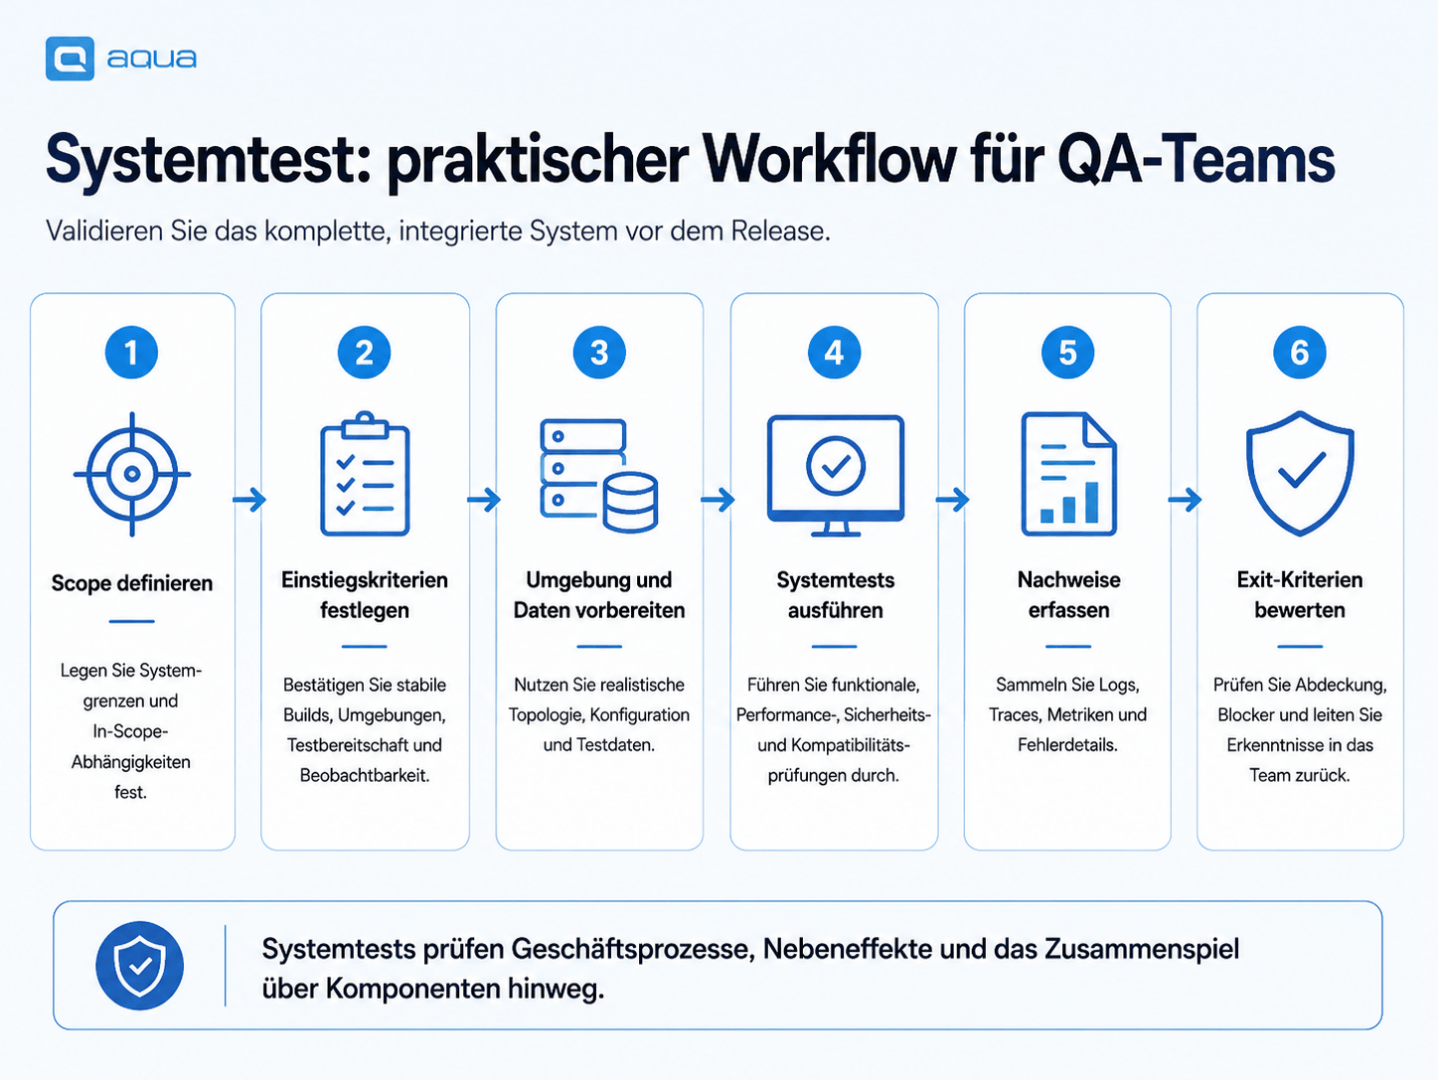
Der Prozess unterteilt sich in sechs Schritte, von der Definition des Umfangs bis zur Rückführung von Produktionsvorfällen in den nächsten Release-Zyklus. Das Überspringen eines Schritts früh erhöht typischerweise die Kosten später, wenn ein Defekt eine Phase erreicht, die ihn hätte erkennen sollen.
- Umfang definieren. Ihr Team beginnt mit der Festlegung der Systemgrenze: Anwendungen, Services, Datenbanken, Integrationen, Umgebungen und Drittanbieter-Abhängigkeiten, die in den Umfang fallen. Ein klarer Umfang reduziert Eigentumsprobleme und macht Abdeckungsentscheidungen einfacher gegenüber Stakeholdern zu erklären.
- Eintrittskriterien festlegen. Bevor der QA-Systemtest beginnt, bestätigt Ihr Team, dass der Build, die Umgebung, die Konfiguration, die Testdaten und die Observability-Fähigkeiten ausreichend ausgereift sind für eine aussagekräftige Validierung. Dies verhindert, dass Engineering-Kapazität für Builds aufgewendet wird, die noch nicht für eine Systemtest-Bewertung bereit sind.
- Umgebung und Testdaten vorbereiten. Ihr Team richtet die Testumgebung überall dort an der Produktion aus, wo Unterschiede Zuverlässigkeit, Performance, Sicherheit oder Kompatibilität beeinflussen könnten. Testdaten sollten realistische Workflows, Edge Cases und Fehlerbedingungen darstellen und gleichzeitig sichere und wiederholbare Ausführung unterstützen.
- Systemtests ausführen. Ihr Team bewertet vollständige Geschäftsabläufe zusammen mit nicht-funktionalen Risiken wie Leistung, Widerstandsfähigkeit und Sicherheit. Kompatibilität, Migrations- und Wiederherstellungsszenarien runden die Abdeckung ab. Priorität haben dabei in der Regel die Abläufe, bei denen ein Ausfall die größten Auswirkungen auf Kunden, den laufenden Betrieb oder die Finanzen hätte.
- Beweise erfassen. Ihr Team stützt Testergebnisse auf Protokolldaten, Kennzahlen und Ablaufverfolgungen sowie, wo relevant, auf Zeitmessungen und Bildschirmaufnahmen. Fehler werden anschließend nach ihren geschäftlichen Auswirkungen und der Dringlichkeit für den Release bewertet, was Stakeholdern eine klarere Grundlage dafür gibt, ob ein festgestelltes Problem hinnehmbar, behebbar oder release-blockierend ist.
- Austrittskriterien bewerten. Ihr Team berücksichtigt Anforderungsabdeckung, ungelöste Defekte und Performance-Schwellenwerte gegen operatives Risiko und die Zuverlässigkeit der verfügbaren Beweise. Produktionsvorfälle und Post-Release-Erkenntnisse informieren dann zukünftige Abdeckung, Umgebungsdesign und Release-Kontrollen und schaffen einen kontinuierlichen Verbesserungszyklus.
Wer führt Systemtests durch?
Die Eigentümerschaft von QA-Systemtests hat keine feste Antwort mehr, und diese Mehrdeutigkeit selbst verursacht Probleme, wenn niemand ein fehlschlagendes Szenario beansprucht. Die Verantwortung hängt von Ihrem Liefermodell ab, und die meisten Organisationen teilen die Arbeit auf mehrere Rollen auf, anstatt sie bei einem einzelnen Team zu parken.
- Speziell dafür abgestellte QA-Ingenieure übernehmen in Organisationen mit eigenen Testteams häufig Planung, Konzeption und Durchführung – sie bringen ihr Testing-Know-how ein und verwalten Testumgebungen und Testdaten.
- In agilen und DevOps-geprägten Umgebungen schreiben Entwicklerinnen und Entwickler zunehmend selbst automatisierte Tests auf Systemebene und tragen so gemäß dem Prinzip „wer baut, testet auch“ gemeinsam Verantwortung für die Produktqualität.
- Site Reliability Engineers bringen eine betriebliche Perspektive ein und konzentrieren sich auf Widerstandsfähigkeit, Beobachtbarkeit sowie kontrollierte Testfreigaben, die sich mit reinen Tests vor dem Release allein nicht abbilden lassen.
- Sicherheitsspezialisten führen Penetrationstests und Konfigurationsprüfungen gemeinsam mit QA und Entwicklung durch und sorgen so dafür, dass Sicherheitstests vom frühen Entwurf bis zum Release durchgehend im Blick bleiben.
- In interdisziplinären Teams verteilt sich die Verantwortung noch weiter: Product Owner definieren die Abnahmekriterien, Designer prüfen die Benutzerfreundlichkeit, und Entwicklerinnen und Entwickler bauen die Automatisierung, die alles miteinander verbindet.
Die Testverantwortung bewegt sich weiter weg von isolierten Gatekeeper-Teams hin zu eingebetteten Qualitätspraktiken, bei denen jeder in Ihrem Team die Verantwortung für Release-Entscheidungen teilt.
Häufig verwendete Tools für Systemtests
Tools auszuwählen, bevor der Umfang definiert wird, ist ein häufiger Fehler. Das richtige Toolkit folgt daraus, was Sie validieren, und hängt davon ab, wie Ihr Team Software liefert:
- Test-Automatisierungs-Frameworks: Selenium und Playwright für Browser-basiertes Testen, Cypress für integrierte Automatisierung mit eingebautem Debugging, REST Assured und Postman für API-Tests.
- Performance- und Load-Testing: JMeter und Gatling für gleichzeitige Traffic-Simulation, Locust für Python-basiertes Scripting, K6 für entwicklerfreundliches Performance-Testing.
- CI/CD-Plattformen: Jenkins, GitLab CI, GitHub Actions und Azure DevOps, um Tests über Commit-, Merge- und Deployment-Phasen auszuführen.
- Container und Orchestrierung: Docker für konsistente Umgebungen, Kubernetes für realistisches verteiltes Testen im großen Maßstab.
- Observability-Tools: Grafana und Prometheus für Metriken, Elastic Stack für Logs, Jaeger und Zipkin für verteiltes Tracing.
- Sicherheitstests: OWASP ZAP und Burp Suite für dynamisches Scanning, Snyk für Dependency-Schwachstellen, SonarQube für Code-Level-Probleme.
- Testdatenmanagement: Delphix und GenRocket für synthetische Datengenerierung, Tonic und K2View für sicheres Maskieren von Produktionsdaten.
Die stärksten Toolchains integrieren sich sauber und melden Ergebnisse konsistent, sodass Ihr Team klare Diagnoseinformationen erhält, sobald ein Test fehlschlägt. Vermeiden Sie Tool-Wildwuchs und wählen Sie das, was ein echtes Problem für Ihr Team löst, anstatt das, was auf einer Folie nur gut aussieht. Die meisten Teams führen diese Tools getrennt aus, wobei Testfälle, Ausführungsergebnisse und Defektberichte in verschiedenen Systemen ohne gemeinsame Rückverfolgbarkeit leben. Diese Trennung ist, wo eine verbundene Plattform ihren Platz im Stack verdient.
Best Practices für effektive Systemtests
Die meisten Teams kennen bereits die Lehrbuchratschläge: Früh testen, nach Risiko priorisieren, Tests unabhängig halten. Was tatsächlich den Unterschied macht, ist spezifischer. Diese vier Praktiken zielen auf die Fehlerpunkte ab, die die meiste Nacharbeit in echten Systemtestsuiten verursachen, von Schema-Drift zwischen Services bis zu flaky parallelen Läufen.
1. Verankern Sie Ihre mehrschichtige Strategie auf Vertragstests
Unit-Tests decken Logikfehler auf, erkennen aber nicht, wenn ein Service still und heimlich sein Antwortschema ändert. Ergänzen Sie deshalb konsumentengetriebene Vertragstests – etwa mit einem Tool wie Pact – zwischen den Services, auf die Ihre Systemtests angewiesen sind. So schrumpft Ihre Systemtest-Suite auf die Szenarien, die tatsächlich den vollständigen Zusammenschluss aller Systeme erfordern, statt aufwendige End-to-End-Durchläufe für etwas einzusetzen, das ein Vertragstest in Sekunden abfangen würde.
2. Risiko als Produkt aus Wahrscheinlichkeit und Auswirkung bewerten
Erstellen Sie für Ihre Arbeitsabläufe eine einfache Risikomatrix: auf der einen Achse die Wahrscheinlichkeit eines Ausfalls, auf der anderen die geschäftliche Auswirkung. Ein Wiederholungspfad bei Zahlungen mit mittlerer Ausfallwahrscheinlichkeit, aber schwerwiegender Auswirkung, wiegt schwerer als eine selten genutzte Admin-Oberfläche mit derselben Ausfallwahrscheinlichkeit. Setzen Sie Ihre begrenzten Ressourcen für Systemtests zuerst dort ein, wo das Risiko am höchsten ist, und überprüfen Sie die Matrix bei jedem Release erneut, da sich das Risiko mit jeder Änderung am Code verschiebt.
3. Isolieren Sie Testdaten mit ephemeren Tenants
Gemeinsam genutzte Testkonten sind die häufigste Ursache für instabile, parallel laufende Testdurchläufe. Richten Sie stattdessen für jeden Testlauf einen eigenen, temporären Mandanten oder Namensraum ein, befüllen Sie ihn programmatisch mit Daten und entfernen Sie ihn nach der Ausführung wieder. Kombinieren Sie dies mit gezielten Wartezeiten, die sich am tatsächlichen Anwendungszustand orientieren – etwa durch wiederholtes Abfragen einer Schnittstelle, bis sich ein Aufgabenstatus ändert – statt mit festen Wartezeiten, die für den Großteil der verbleibenden Instabilität verantwortlich sind.
4. Mit Korrelations-IDs und Testergänzungen nach Störfällen den Kreis schließen
Anfragen, die Ihre Systemtests erzeugen, sollten eine Korrelations-ID mitführen, die sich durch Protokolldaten, Ablaufverfolgungen und Kennzahlen zieht, sodass sich ein fehlgeschlagener Test direkt einer bestimmten Ablaufverfolgung in Jaeger oder Datadog zuordnen lässt. Kommt es zu einem Störfall im laufenden Betrieb, sollte die anschließende Aufarbeitung als verpflichtender Input für Ihren Testrückstand behandelt werden. Ergänzen Sie das fehlende Szenario, verschärfen Sie die Prüfbedingung, die den Fehler eigentlich hätte erkennen müssen, und behalten Sie im Blick, wie viele Störfälle auf Lücken zurückzuführen sind, die Ihre Systemtests eigentlich hätten abdecken sollen.
Systemtests prüfen die Eigenschaften des Systems oder einzelner Systembestandteile. Abnahmetests können sich zwar ähnlichen Aspekten widmen, stehen jedoch meist im Zeichen der Validierung. Beide beantworten unterschiedliche Fragen: Was wird getestet (Systemtest) im Gegensatz zu wozu beziehungsweise warum wird getestet (Abnahmetest).
SmileRelaxAttack
Gepostet in
Reddit
Häufige Herausforderungen bei Systemtests und wie man sie angeht
Selbst gut geplante Systemtests stoßen auf wiederkehrende operative Probleme, und die meisten lassen sich auf Umgebungs- und Datenmanagement zurückführen, nicht auf das Testdesign selbst.
| Herausforderung |
Operative Konsequenz |
Reaktion |
| Umgebungs-Drift |
Tests bestehen in QA, scheitern aber in Produktion |
Infrastruktur versionieren und Konfiguration validieren |
| Instabile externe Services |
Falsche Fehler und blockierte Ausführung |
Sandboxes, Service-Virtualisierung und Fallback-Szenarien verwenden |
| Testdaten-Kollisionen |
Flaky parallele Läufe |
Tenants, Konten und Identifikatoren isolieren |
| Lange Ausführungszeit |
Langsames Release-Feedback |
Smoke-, Regressions- und geplante Suiten trennen |
| Schwierige Root-Cause-Analyse |
Langsame Triage über Services hinweg |
Korrelations-IDs, Logs, Traces und Build-Metadaten bewahren |
| Übermäßige E2E-Abdeckung |
Teure und spröde Suite |
Systemtests auf funktionsübergreifende Geschäftsrisiken fokussiert halten |
Umgebungs-Drift macht die Root-Cause-Analyse schwieriger, da Ihr Team nicht feststellen kann, ob ein Fehler einen echten Defekt oder eine Konfigurationsinkongruenz widerspiegelt. Testdaten-Kollisionen verlangsamen die parallele Ausführung, was Teams zu weniger, größeren Testläufen drängt, die die Ausführungszeit weiter verlängern. Die Behebung der Grundursache, anstatt einzelne Symptome zu patchen, hält die Suite schnell und die Ergebnisse vertrauenswürdig.
Eine Systemteststrategie ist nur so effektiv wie die dahinterstehende Tooling. Die meisten Teams verwalten QA über getrennte Systeme, wobei Testfälle an einem Ort, Anforderungen an einem anderen und Automatisierungsergebnisse über CI-Logs verstreut sind. aqua cloud, eine KI-gesteuerte Test- und Anforderungsmanagement-Plattform, vereint den gesamten QA-Prozess auf einer Plattform. aqua Intelligence verwendet RAG Grounding, um den Kontext Ihres Projekts zu verstehen und umfassende Systemtestszenarien in Sekunden mit Testfällen zu generieren, die zur Sprache Ihres Produkts passen. Komplexe Workflows werden durch wiederverwendbare verschachtelte Testfälle, parametrisierte Testdaten und Umgebungstracking verwaltet. Die Ausführung wird über manuelle und automatisierte Systemtestläufe durch Echtzeit-Dashboards verfolgt, die Abdeckung und Risikoexposition zeigen. aqua verbindet sich durch 10+ native Automatisierungsintegrationen, einschließlich JMeter, PowerShell, MSSQL- und Oracle-Datenbanken, UnixShell, SoapUI, Ranorex und REST-API-Zugriff. Capture rundet die Beweiskette ab und zeichnet die Testausführung mit Video und Screenshots auf.
Eine Systemteststrategie ist nur so effektiv wie die dahinterstehende Tooling. Die meisten Teams verwalten QA über getrennte Systeme, wobei Testfälle an einem Ort, Anforderungen an einem anderen und Automatisierungsergebnisse über CI-Logs verstreut sind. aqua cloud, eine KI-gesteuerte Test- und Anforderungsmanagement-Plattform, vereint den gesamten QA-Prozess auf einer Plattform. aqua Intelligence verwendet RAG Grounding, um den Kontext Ihres Projekts zu verstehen und umfassende Systemtestszenarien in Sekunden mit Testfällen zu generieren, die zur Sprache Ihres Produkts passen. Komplexe Workflows werden durch wiederverwendbare verschachtelte Testfälle, parametrisierte Testdaten und Umgebungstracking verwaltet. Die Ausführung wird über manuelle und automatisierte Systemtestläufe durch Echtzeit-Dashboards verfolgt, die Abdeckung und Risikoexposition zeigen. aqua verbindet sich durch 10+ native Automatisierungsintegrationen, einschließlich JMeter, PowerShell, MSSQL- und Oracle-Datenbanken, UnixShell, SoapUI, Ranorex und REST-API-Zugriff. Capture rundet die Beweiskette ab und zeichnet die Testausführung mit Video und Screenshots auf.
Sparen Sie 98% der Testerstellungszeit mit KI-gestützten Systemtests
Fazit
Komplexe Systeme sind nie perfekt, und Systemtests versuchen nicht, sie perfekt zu machen. Sie reduzieren Unsicherheit und geben Ihrem Team Beweise für Release-Entscheidungen. Behandeln Sie sie als eine Ebene in einer breiteren Qualitätsstrategie, die Anforderungen, Architektur und Produktionstelemetrie verbindet. Wenn Vorfälle auftreten, geben Sie diese Lehren zurück in Ihre Teststrategie, sodass die Abdeckung zusammen mit Ihrem Produkt wächst.